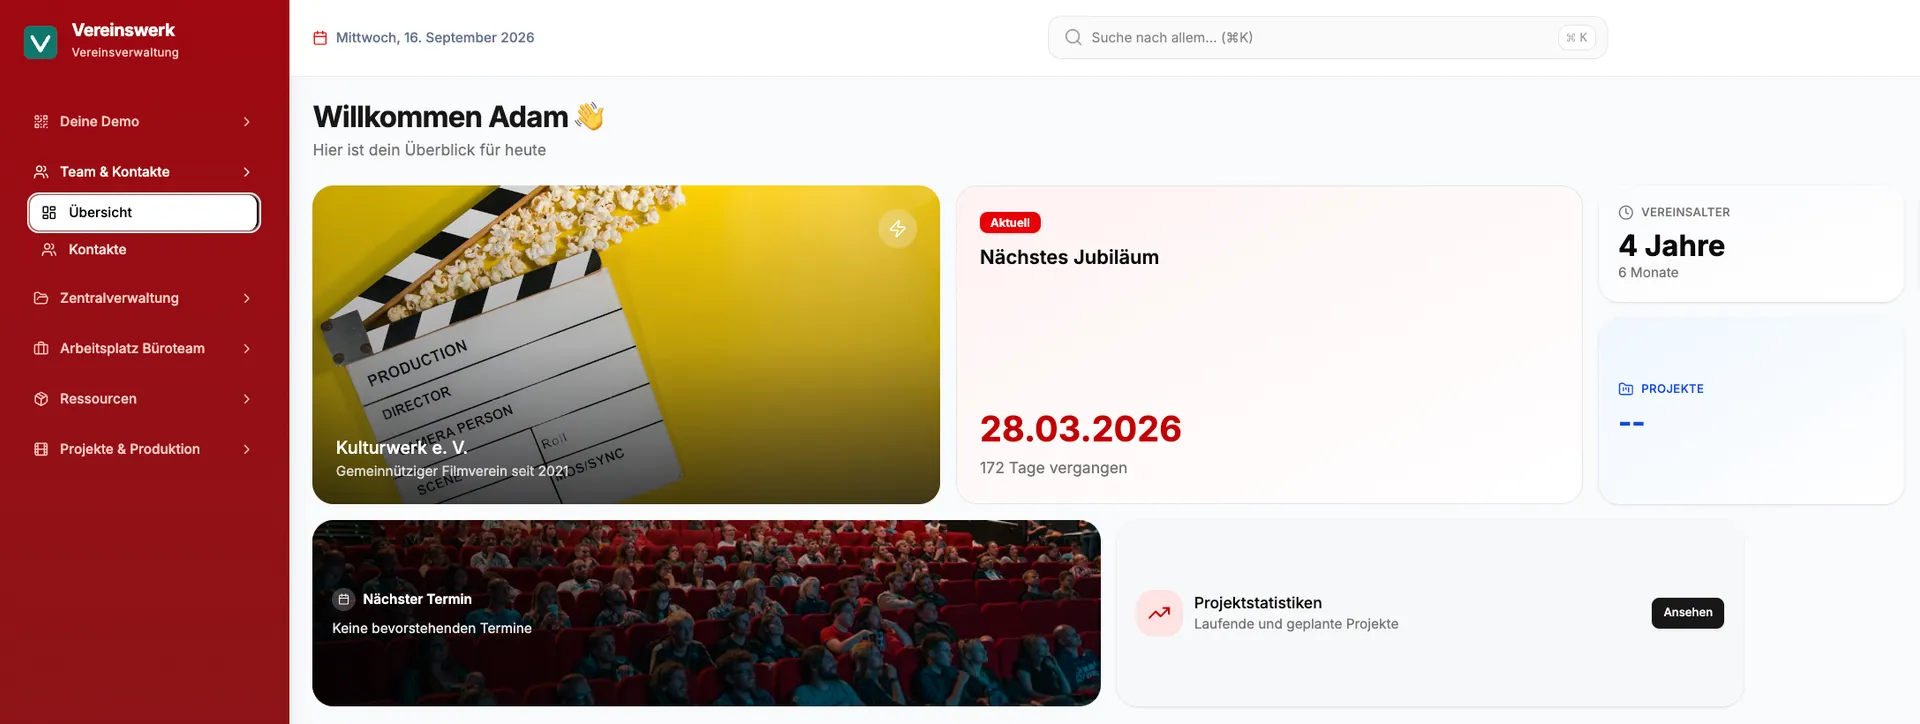
Ein Verein, der Sendungen produziert, führt statt Mitgliedern Gremien, Produktionen, Verträge. Mangels Software entstand eine eigene. Was gelernt und warum die Versionsgeschichte neu gewurzelt wurde.
01 — Der Gegenstand
Vereinssoftware gibt es reichlich. Sie verwaltet Mitglieder, Beiträge und Einladungen zur Jahreshauptversammlung. Ein Verein, dessen Zweck die Produktion ist, braucht etwas anderes: Wer ist am Drehtag wo eingeteilt, welche Fassung des Drehbuchs gilt, wer hat den Vertrag unterschrieben, welches Gremium hat es beschlossen.
Entstanden sind daraus dreizehn Bereiche, die sich gegenseitig kennen. Die Disposition plant Menschen und Termine gegeneinander. Das Drehbuch wird von mehreren gleichzeitig bearbeitet und hält jede Fassung. Verträge gehen zur Unterschrift hinaus und kommen signiert zurück. Dazu Kontakte, Dokumente mit Vertraulichkeitsstufen, ein Wiki, ein Passwort-Tresor, E-Mail-Vorlagen und eine Rechteverwaltung, die zwischen Vorstand, Vorstandsassistenz, Büroteam und Mitgliedern unterscheidet.
Nichts davon ist für sich genommen schwierig. Schwierig ist, dass es zusammenpassen muss: Ein Vertrag hängt an einer Produktion, die Produktion an einer Disposition, die Disposition an Menschen, die auch Kontakte sind.
02 — Umfang
Quelldateien
614Zeilen Code
98.866Tests
307Bereiche
13KI-Sitzungen
87Gesprächsdaten
75 MBDie letzten beiden Zahlen sind die ehrlichsten. Der Code ist mit KI-Unterstützung entstanden, und der Aufwand steckt nicht im Tippen, sondern im Gespräch: 83 Sitzungen, aus denen 75 MB Protokoll übrig sind. Wer ausrechnet, wie viel davon auf jede Codezeile entfällt, bekommt ein realistischeres Bild von dieser Arbeitsweise als jede Demonstration.
03 — Zwei Entscheidungen
Mehrere Menschen bearbeiten dasselbe Drehbuch gleichzeitig. Die erste Fassung löste das mit Durable Objects bei Cloudflare — je Dokument ein Objekt, das den Zustand hält. Das funktionierte und hat trotzdem nicht getragen: Der Rest der Anwendung lief woanders, und für jede Änderung mussten zwei Laufzeitumgebungen zusammenpassen.
Ersetzt wurde es durch einen Node-Beiwagen im selben Prozess, mit identischem Protokoll. Ein Port bedient alles, der Zustand liegt direkt in der Datenbank statt in einem fremden Dienst, und die Anwendung lässt sich lokal vollständig starten. Der Schritt hat Fähigkeiten gekostet und Zusammenhang gebracht — für ein Projekt, das noch jahrelang gepflegt werden soll, ist das der bessere Tausch.
Für die öffentliche Demo stellte sich die übliche Frage: Wie zeigt man eine Anwendung, in der jeder alles verändern kann, ohne dass der zweite Besucher die Spuren des ersten vorfindet? Der übliche Weg — nächtliches Zurücksetzen — bedeutet, dass die Demo tagsüber allmählich verfällt.
Stattdessen bekommt jeder Besucher eine eigene Datenbank, kopiert aus einer gesäten Vorlage:
CREATE DATABASE "templated_datenbank" TEMPLATE "seed_datenbank"Postgres kopiert die Vorlage physisch. Die Umgebung lebt 48 Stunden nach der letzten Nutzung, höchstens sieben Tage, und lässt sich per achtstelligem Code oder QR-Code an Kollegen weitergeben, die dann im selben Stand weiterarbeiten. Ein Aufräumer entfernt, was abgelaufen ist. Die Trennung liegt damit nicht in der Anwendung, sondern eine Ebene darunter: Zwei Besucher können sich nicht sehen, weil sie nicht in derselben Datenbank sind.
04 — Arbeitsweise
Eine Sache hat mehr Fehler gefunden als alles andere: einen Test nicht zu glauben, bevor man ihn hat fallen sehen. Mehrfach stand in einem Prüfbericht, eine Eigenschaft sei abgesichert — und als die Absicherung testweise entfernt wurde, blieb alles grün. Der Test prüfte etwas Benachbartes.
Ein Beispiel aus dem Projekt: Eine Prüfung sollte sicherstellen, dass die Anwendung das Signaturverfahren eines Tokens festnagelt. Der naheliegende Testaufbau — Kopfzeile auf das eine Verfahren umschreiben, tatsächlich mit dem anderen signieren — unterscheidet nichts: Die Bibliothek rechnet ohnehin mit dem Verfahren aus der Kopfzeile und lehnt so oder so ab. Erst ein anderer Aufbau fällt um, wenn die Festnagelung fehlt. Ohne diese Gegenprobe hätte dort jahrelang ein Test gestanden, der nichts bewacht.
Ein Test, den man nicht hat fallen sehen, ist kein Test. Er ist eine Behauptung mit Einrückung.
Das Zweite: Spezifikation zuerst, dann Tests, dann Code. Nicht aus Rechtgläubigkeit, sondern weil eine KI jede Lücke in der Beschreibung plausibel füllt. Was nicht aufgeschrieben ist, wird erfunden — und erfundene Annahmen sind später teurer zu finden als jede offen gelassene Frage.
05 — Die Geschichte
Das Projekt sollte öffentlich vorführbar werden. Der Auftraggeber bleibt ungenannt, seine Daten bleiben seine. Also: Namen raus, Beispieldaten rein, Marke ersetzen. Das Verzeichnis war danach sauber. Jede Datei, die nicht hätte da sein dürfen, war gelöscht.
Gelöscht heißt in Git aber nicht: weg. Eine Datei, die in einem Commit lag und im nächsten entfernt wurde, liegt weiterhin im ersten. Der Wurzel-Commit dieses Repositories trug 558 später gelöschte Dateien.
Alles davon wäre beim ersten git clone wieder da gewesen.
Die Behebung bestand aus zwei Schritten. Erst wurden die verbliebenen Bezeichner aus sämtlichen Commits ersetzt, dann bekam das Repository eine neue Wurzel: Ein späterer, sauberer Commit wurde zum ersten erklärt, alles davor abgeschnitten.
git filter-repo --force --replace-text …   # Bezeichner ersetzen
git replace --graft 0d7bc96                # neue Wurzel setzen
Seither beginnt die Geschichte des Projekts an dem Tag, an dem sie vorzeigbar wurde. Was davor lag, existiert nicht mehr — auch nicht in einem alten Objekt, das ein Werkzeug irgendwann wieder ausgräbt.
Eine einmalige Säuberung hält genau bis zum nächsten unachtsamen Commit. Deshalb steht seither eine Kette von fünf Prüfungen davor, von denen jede etwas fängt, das die anderen nicht sehen können: .gitignore für Bekanntes, eigene Muster für projektspezifische Begriffe, ein Werkzeug mit rund 170 gepflegten Anbieter-Regeln, eine KI-Durchsicht für das, was Muster nicht kennen können — und ein Lauf in der Fremde, außerhalb der eigenen Reichweite, weil die ersten vier auf dem eigenen Gerät mit einem einzigen Schalter stillzulegen sind.
Auch die Commit-Nachricht wird geprüft. Sie liest sonst keine der anderen Schichten, und ein Kundenname, in git commit -m getippt, landet genauso unwiderruflich in der Historie wie eine Datei.
Die Liste der Begriffe, die nicht vorkommen dürfen — Firmenname, Produktnamen, interne Kürzel — liegt dabei bewusst nicht im Repository. Sonst enthielte ausgerechnet das Projekt, das die Namen nicht nennen soll, eine sortierte Liste genau dieser Namen.
Der Mechanismus ist versioniert, die Begriffe sind es nicht.
Was bleibt, ist ein Repository, in dem █████████ nicht vorkommt, ███████████████ nicht vorkommen und die Demo trotzdem echte Arbeitsabläufe zeigt — mit Beispieldaten, die aussehen wie der Betrieb, und niemandem gehören.
06 — Fazit